重複コンテンツとは、同じ内容や、ほとんど同じ内容のページが、複数の URL で見られる状態のことです。Google は、通常の重複コンテンツをペナルティの対象とはしていません。似たページの中から代表の URL を 1 つ選び、それを検索結果に表示します。問題になるのは、表示してほしいページが代表に選ばれなかったり、評価が複数の URL に分かれたりすることです。この記事では、Google 検索セントラルの公式ドキュメントに沿って、重複コンテンツの考え方、調べ方、ケース別の対処法をまとめます。
重複コンテンツとは?Google が「同じページ」とみなす範囲
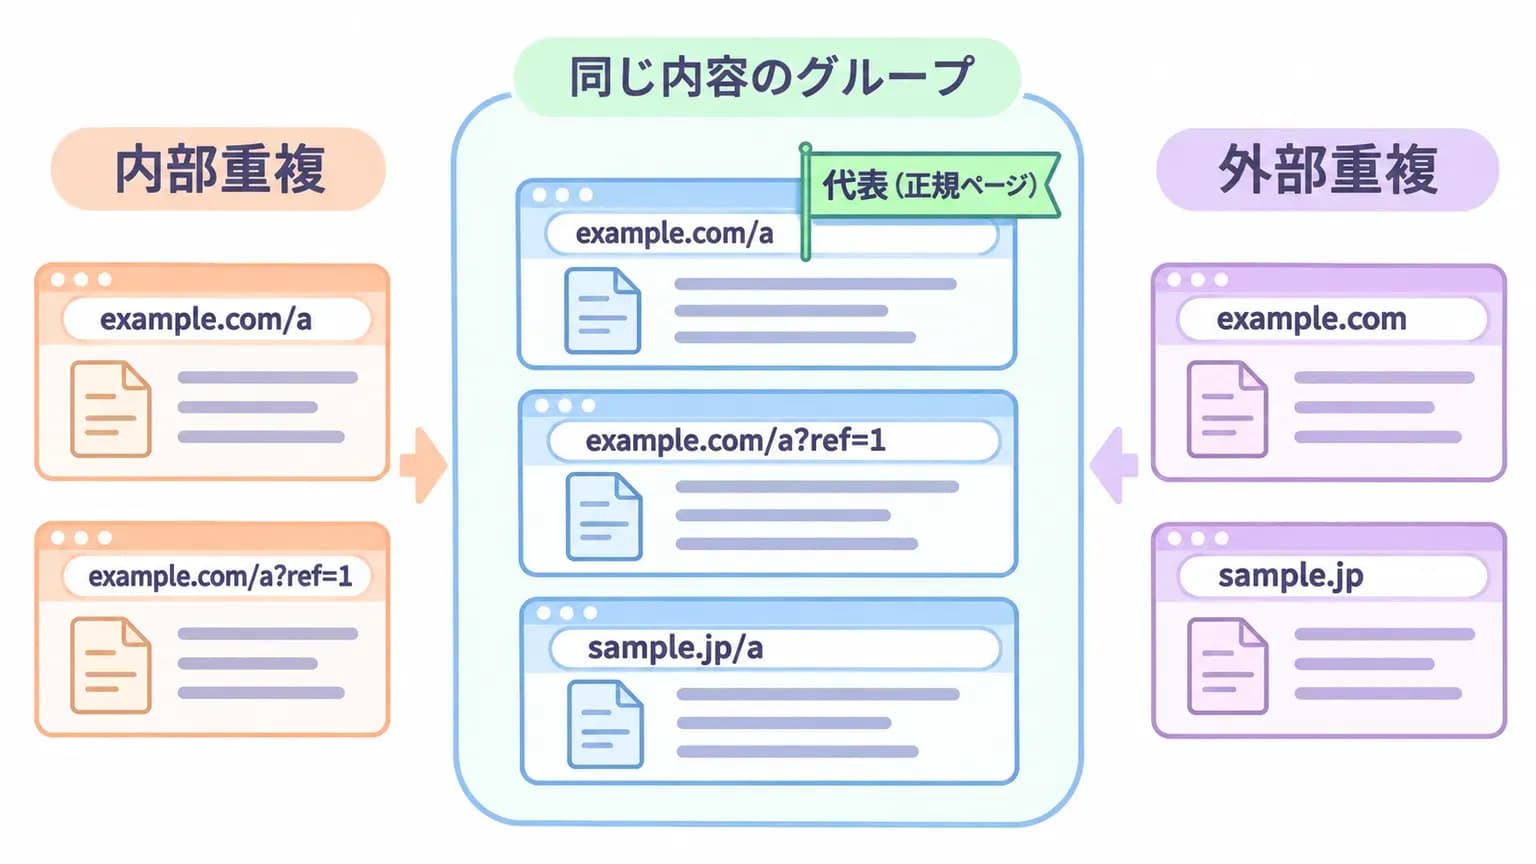
重複コンテンツは、サイトの中で起きるもの(内部重複)と、ほかのサイトとの間で起きるもの(外部重複)の 2 つに分けられます。どちらも、悪意がなくても日常的に起こるものです。
Google は、同じに見えるページや、主要な内容がとてもよく似たページを見つけると、それらを 1 つのグループにまとめます。そのうえで、利用者にとって最も充実していて役に立つページを「正規ページ(代表の URL)」として選びます(Google 検索セントラル: 正規化とは)。
サイト内の重複(内部重複)
内部重複は、同じサイトの中で、同じ内容のページに複数の URL からたどり着ける状態です。多くは、URL の書き方の違いやサイトの仕組みから生まれます。
- www の有無(example.com と www.example.com)
- http と https の混在
- 末尾のスラッシュの有無(/about と /about/)
- 並べ替えや絞り込みのパラメータ付き URL(?sort=price など)
- PC 用とスマートフォン用で URL を分けているページ
- 誤って公開されたままのテスト環境
他サイトとの重複(外部重複)
外部重複は、別のドメインに同じ文章が載っている状態です。記事をほかのメディアへ配信した場合のように正当なものもあれば、無断でコピーされた場合もあります。
自社サイトの内容を別ドメインに丸ごと複製した「ミラーサイト」も外部重複にあたります。ミラーサイトの扱いはミラーコンテンツの使い分け方で詳しく説明しています。
どのくらい似ていると重複になるのか
「何%一致したら重複」という数値の基準は、Google から公表されていません。判断の軸になるのは、ページの「主要な内容」が同じかどうかです。
ヘッダーやフッター、サイドバーなど、どのページにも共通する部分が同じでも問題はありません。一方で、本文がほぼ同じで、地名や商品名だけを入れ替えたページは、重複とみなされやすくなります。なお、本文を別の言語に翻訳したページは、重複にはあたりません。
重複コンテンツにペナルティはあるのか
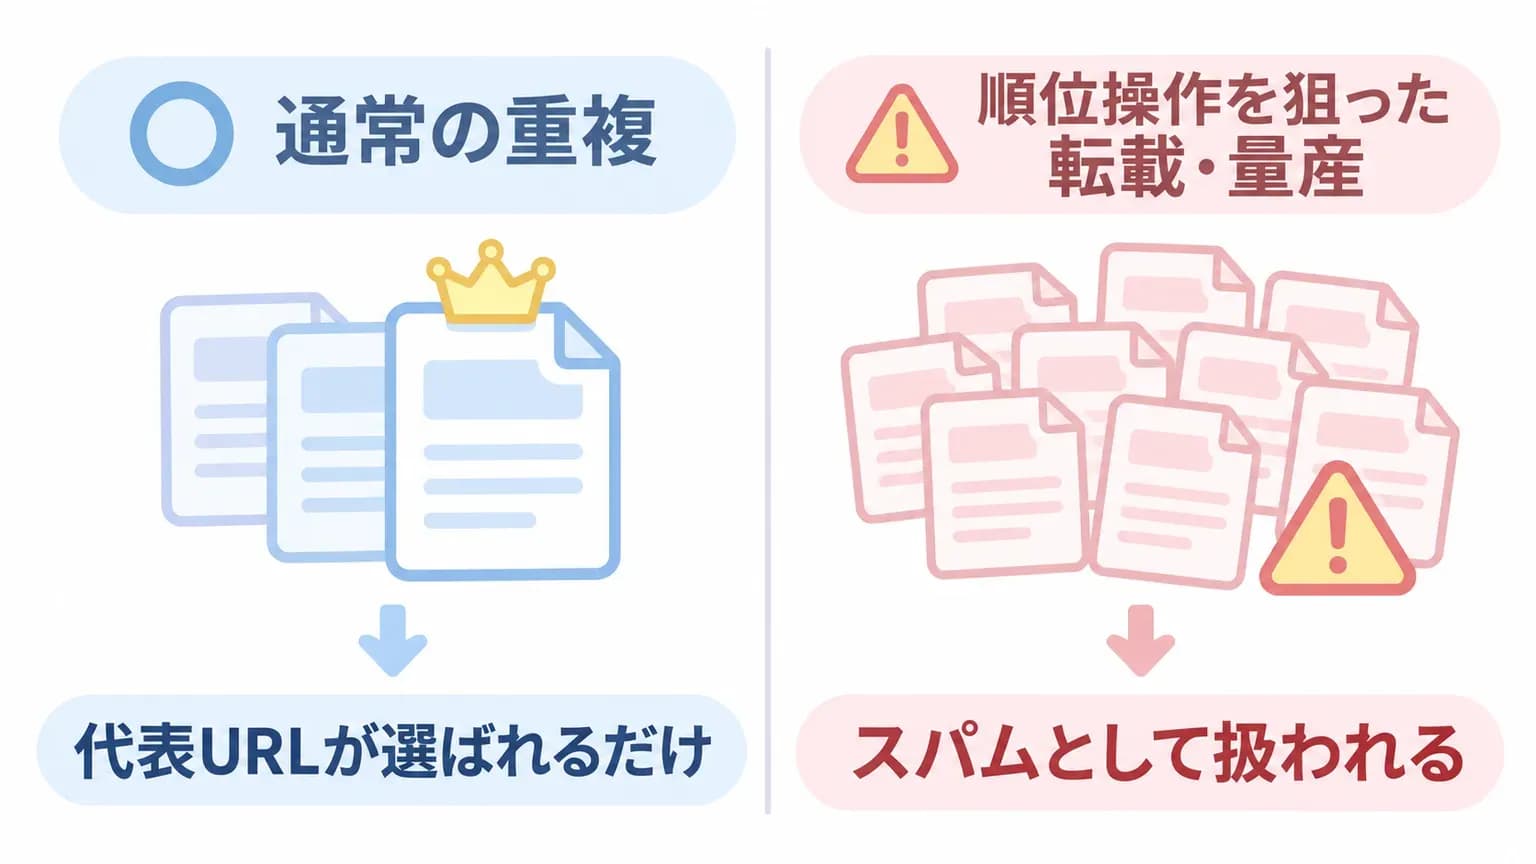
通常の重複コンテンツに、ペナルティはありません。Google は「サイト内にある程度の重複コンテンツがあるのは普通のことで、スパムに関するポリシーへの違反ではない」と説明しています(Google 検索セントラル: 正規化とは)。
ただし、検索順位を操作する目的で作られた重複は別です。このようなページは、スパムとして順位を下げられたり、検索結果から除かれたりすることがあります。
通常の重複は「代表 URL が選ばれる」だけ
Google は 2008 年の公式ブログで「『重複コンテンツのペナルティ』というものは存在しない」と述べています(Google 検索セントラル ブログ: 「重複コンテンツのペナルティ」を解明する)。現在のドキュメントでも、似たページはグループにまとめられ、代表の URL が 1 つ選ばれるという扱いです。
つまり、通常の重複で起きるのは「降格」ではありません。「同じグループのうち、どの URL が検索結果に出るか」が Google に委ねられる、ということです。
問題になるのは、検索順位の操作を狙った重複
Google のスパムに関するポリシーでは、次のような行為が違反の例として挙げられています(Google 検索セントラル: Google ウェブ検索のスパムに関するポリシー)。
- ほかのサイトの文章を、独自の価値を加えずに転載する(スクレイピング)
- ほかのサイトの文章を少しだけ言い換えて掲載する
- 生成 AI などを使って、利用者にとって価値のないページを大量に作る
- 地名だけを変えたような、よく似たページを大量に作って検索結果を占めようとする
自社の運用で自然に生まれる重複と、これらの行為はまったく別のものです。スパムの全体像はSEOスパムの基本ガイドをご覧ください。
重複コンテンツが SEO に与える影響
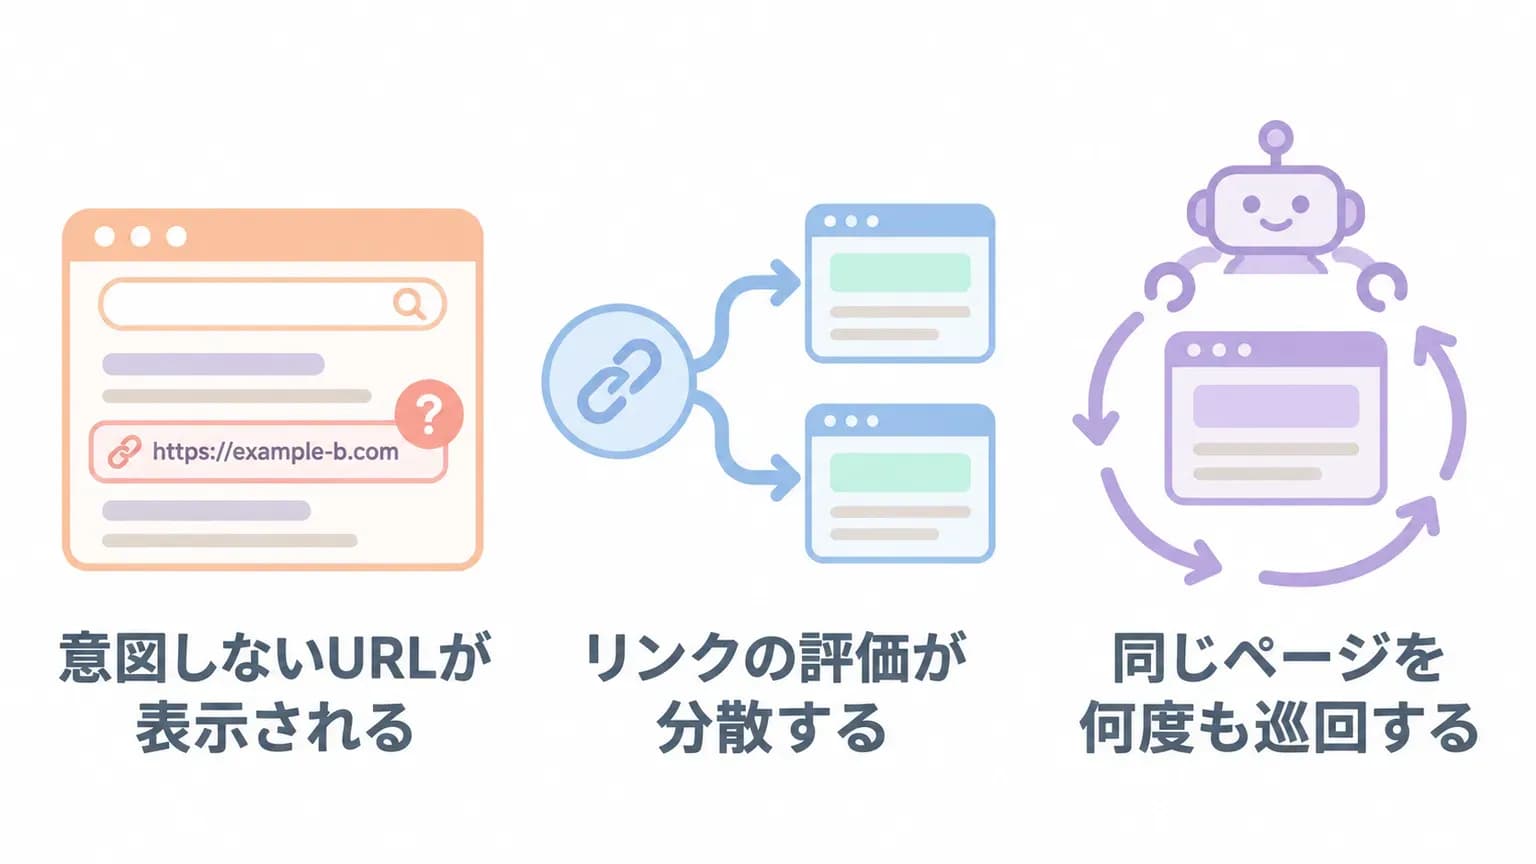
ペナルティがなくても、重複を放っておくと SEO では損をします。主な影響は「表示したいページが選ばれない」「評価が分かれる」「クロールに無駄が出る」の 3 つです。
表示したいページが代表に選ばれない
代表の URL は Google が決めます。そのため、パラメータ付きの URL や古い URL など、本当は表示したくない URL が検索結果に出ることがあります。
被リンクなどの評価が複数の URL に分かれる
同じ内容に複数の URL があると、外部からのリンクも分かれて張られがちです。Google は、正規 URL を指定する理由の 1 つとして、リンクなどの評価を正規 URL にまとめられることを挙げています(Google 検索セントラル: 重複した URL を統合する)。また、アクセス数などの数値も複数の URL に分かれ、成果を把握しにくくなります。
クロールに無駄が生まれる
Google のクローラー(ページを巡回して情報を集めるプログラム)が重複ページを何度も巡回すると、新しいページや更新したページの巡回が後回しになることがあります。ページ数の多いサイトほど、この影響は大きくなります。クローラーの仕組みはクローラーの基礎で解説しています。
重複コンテンツが生まれる主な原因
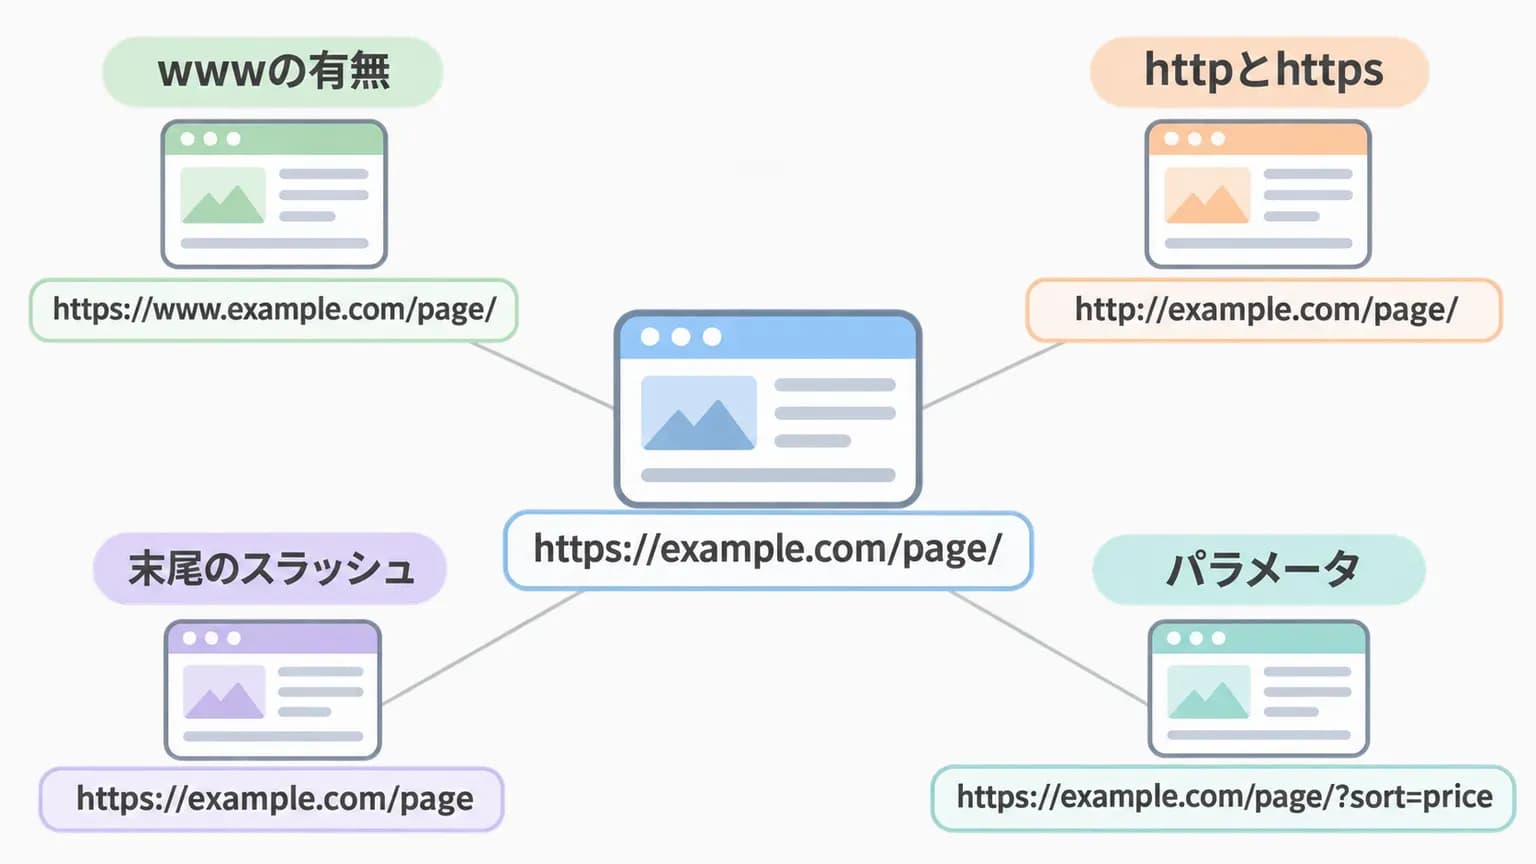
重複の多くは、URL の表記ゆれとサイトの仕組みから生まれます。原因ごとに、まず取るべき対処を表にまとめました。
原因 | 例 | まず取る対処 |
|---|---|---|
www の有無 | example.com と www.example.com | どちらかへ 301 リダイレクト |
http と https の混在 | http:// と https:// の両方で表示される | https へ 301 リダイレクト |
末尾スラッシュ・大文字小文字 | /about と /about/ | 表記をそろえ、片方へ 301 リダイレクト |
URL パラメータ | ?sort=price、?utm_source=... | canonical タグで正規 URL を指定 |
PC 用とスマートフォン用の別 URL | www.example.com と m.example.com | canonical と alternate で関係を示す |
並べ替え・絞り込みページ | 一覧の並び順違い | noindex か robots.txt で対象を絞る |
似た内容の記事・ページ | 同じテーマの記事が複数ある | 1 本に統合して 301 リダイレクト |
テスト環境の公開 | stg.example.com が検索に出る | 認証をかけてクロールさせない |
https への切り替えはHTTPS化の移行手順、URL パラメータの基本はURLパラメータとはとURLパラメータのSEO影響と対処法で詳しく説明しています。
なお、以前サーチコンソールにあった「URL パラメータ ツール」は 2022 年に廃止されました。Google は、パラメータの扱いはクローラーが自動で判断すると説明しています(Google 検索セントラル ブログ: URL パラメータ ツールの廃止)。
重複コンテンツの調べ方
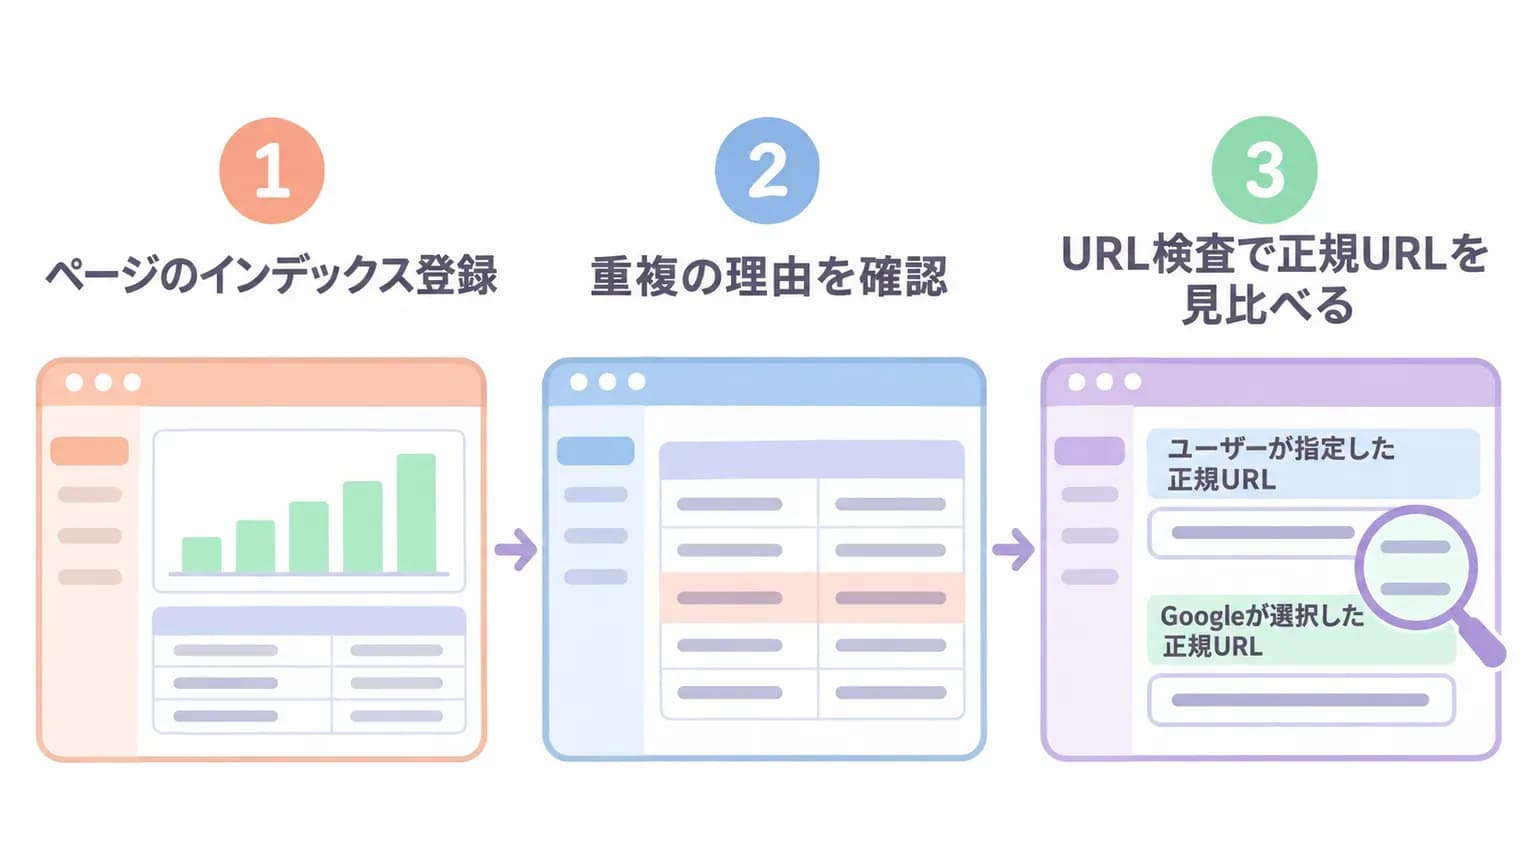
自分のサイトの重複は、サーチコンソール(Google 検索の管理画面)で確かめるのが確実です。そのうえで、検索コマンドやツールを組み合わせると、見落としを減らせます。サーチコンソールをまだ使っていない場合は、サーチコンソールの導入方法から設定してください。
「ページのインデックス登録」レポートで確かめる
サーチコンソールの「インデックス作成」から「ページ」を開くと、検索に登録されていないページとその理由が一覧で見られます。重複に関係する理由は、主に次の 3 つです(Search Console ヘルプ: ページ インデックス登録レポート)。
理由 | 意味 | 対応 |
|---|---|---|
重複していますが、ユーザーが正規ページとして選択していません | 正規 URL を指定していないため、Google が別の URL を代表に選んだ | 表示したい URL が代表になっていれば対応不要。違えば正規 URL を指定する |
重複しています。Google により、ユーザーがマークしたページとは異なるページが正規ページとして選択されました | 自分で指定した正規 URL とは別の URL を、Google が代表に選んだ | 指定先が本当に一番ふさわしいか、内容やリンクを見直す |
代替ページ(適切な canonical タグあり) | 正規 URL の指定が正しく働いている | 通常は対応不要 |
これらはエラーではありません。表示したい URL が代表に選ばれているかどうかを確かめるための情報として使います。
URL 検査で「Google が選択した正規 URL」を確かめる
気になるページは、サーチコンソール上部の検索窓に URL を入れて「URL 検査」を行います。「ページのインデックス登録」の項目に、「ユーザーが指定した正規 URL」と「Google が選択した正規 URL」が表示されます(Search Console ヘルプ: URL 検査ツール)。
2 つが一致していれば、指定どおりに扱われています。違う URL が表示されたら、そのページは重複とみなされ、別の URL が代表に選ばれています。なお、「公開 URL をテスト」(ライブテスト)では、「Google が選択した正規 URL」は表示されません。
検索コマンドで簡易チェックする
サーチコンソールを使えないときは、Google 検索で簡単に確かめられます。
- 「site:example.com」で検索し、同じタイトルのページが複数出ていないか見る
- 本文の特徴的な一文を「"」で囲んで検索し、ほかのサイトに同じ文章がないか見る
あくまで目安なので、結果は URL 検査で確かめ直してください。
ツールを併用する
ページ数が多いサイトでは、サイト全体を巡回するクロールツールを使うと、タイトルや本文が重なっているページをまとめて洗い出せます。他サイトへのコピーを調べるときは、文章の一致率を調べるコピーチェックツールが役立ちます。
重複コンテンツの対処法
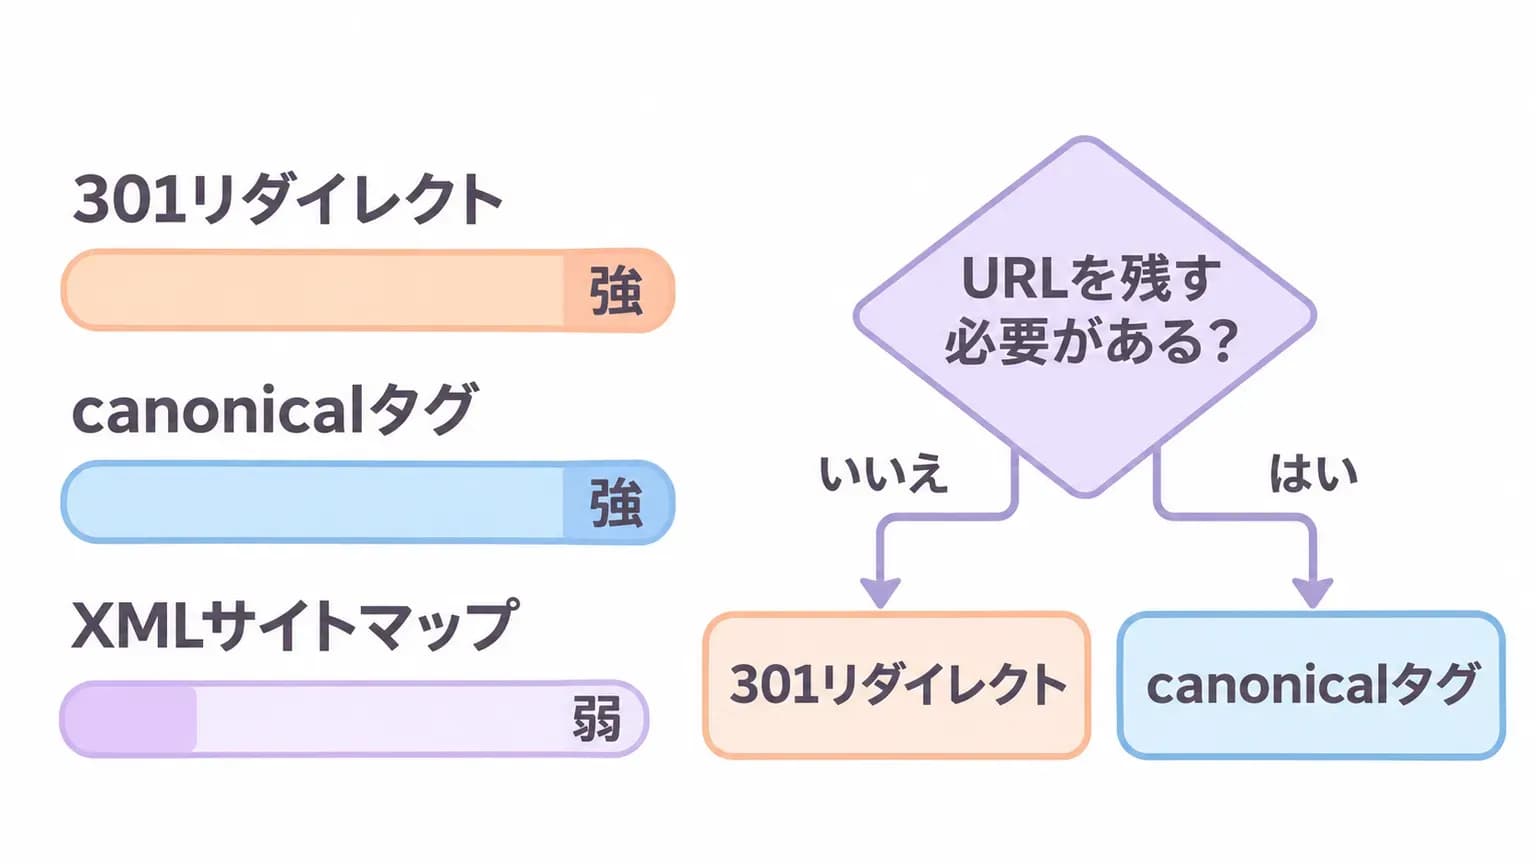
対処の基本は、「どの URL を代表にしてほしいか」を Google に正しく伝えることです。伝え方には強弱があり、Google は次の順で影響が強いと説明しています(Google 検索セントラル: 重複した URL を統合する)。
方法 | 伝わる強さ | 向いている場面 |
|---|---|---|
301 リダイレクト | 強い | 古い URL や不要な URL を、もう見せる必要がないとき |
canonical タグ | 強い | 重複した URL も残しておく必要があるとき |
XML サイトマップに正規 URL だけを載せる | 弱い | ほかの方法と組み合わせて補強するとき |
複数の方法を組み合わせると、より伝わりやすくなります。ただし、どの方法も Google にとっては「ヒント」です。最終的に代表を決めるのは Google なので、指定とページの中身がそろっていることが大切です。
301 リダイレクトで 1 つの URL にまとめる
不要な URL へのアクセスを、正規 URL へ自動で転送します。www の有無や http と https の統一、記事の統合で使う、最も確実な方法です。
一時的な転送に使う 302 リダイレクトは、代表を移したいときには向きません。設定方法はhtaccessでの301リダイレクト設定、使い分けは302リダイレクトとはをご覧ください。
canonical タグで正規 URL を指定する
ページを残したまま、「代表はこちらの URL です」と示す方法です。重複したページの head 内に、次のように書きます。
<link rel="canonical" href="https://example.com/products/shirt/">URL は、https から始まる絶対 URL で書きます。正規 URL のページ自身にも、自分の URL を指す canonical タグを入れておくと安心です。書き方の詳細や注意点はcanonicalタグとはで解説しています。
XML サイトマップと内部リンクを正規 URL にそろえる
XML サイトマップには、正規 URL だけを載せます。サイト内のリンクも、パラメータ付きの URL ではなく正規 URL へ向けてください。指定とサイト内の扱いがそろっていると、Google も迷わずに代表を選べます。サイトマップの作り方はXMLサイトマップとはをご覧ください。
noindex と robots.txt を使うときの注意
noindex は、ページを検索結果から外す指定です。Google は、同じサイト内で代表の URL を決める目的で noindex を使うことは勧めていません。ページが検索から完全に外れ、評価もまとまらないためです。
robots.txt も、代表の URL を決める目的には使わないよう案内されています。robots.txt でブロックした URL でも、内容が読まれないまま登録されることがあるためです。noindex の使いどころはnoindexとnofollowの違い、robots.txt の書き方はrobots.txt書き方ガイドで確認できます。
ケース別の対処法(EC サイト・ブログ・記事配信)
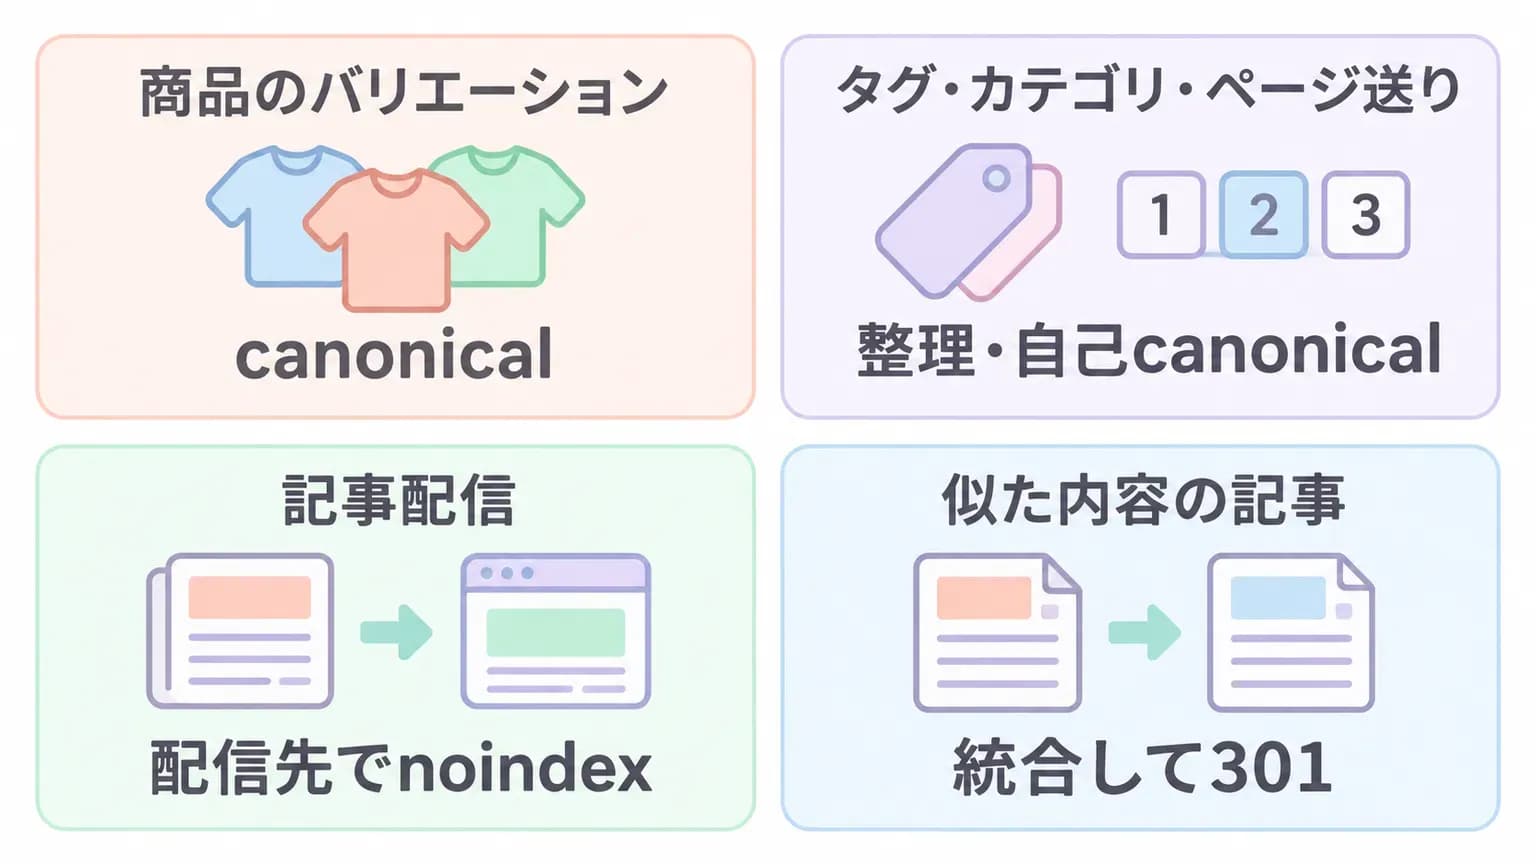
重複の起きやすさはサイトの種類で変わります。よくある 4 つのケースについて、考え方をまとめます。
商品のバリエーション・絞り込みページ
色やサイズだけが違う商品は、1 つのページにまとめて、ページ内で選べるようにするのが基本です。ページを分ける場合は、それぞれの違い(素材、用途、サイズ感など)を説明文に書き足し、使い回しの文章だけのページにしないことが大切です。
一覧ページの並べ替えや絞り込みで生まれる URL は、検索に登録しなくてよいものが大半です。Google は、同じ一覧の並び替え違いを登録させないよう、noindex や robots.txt で対象を絞る方法を案内しています(Google 検索セントラル: ページネーションと段階的な読み込み)。
タグ・カテゴリ・ページネーション
ブログでは、タグページとカテゴリページに同じ記事一覧が並び、中身がほぼ同じになることがあります。役割が重なるタグは整理し、カテゴリページには、そのカテゴリ独自の説明文を入れておくとよいでしょう。カテゴリ設計の考え方はカテゴリ分けの基本ルールをご覧ください。
一覧を複数ページに分ける「ページネーション」では、2 ページ目以降の canonical を 1 ページ目に向けないでください。Google は、各ページにそれぞれ自分の URL を正規 URL として指定するよう案内しています。また、以前使われていた rel="prev" と rel="next" は、Google ではすでに使われていません。各ページを通常のリンクでつなげば、Google は順番にたどれます(Google 検索セントラル: ページネーションと段階的な読み込み)。実装の基本はページネーションとはで解説しています。
他サイトへの記事配信(シンジケーション)
自社の記事をほかのメディアに配信すると、配信先のページが元の記事より上に表示されることがあります。配信先で検索に出したくない場合は、配信先のページに noindex を付けてもらう方法が、Google ニュースのヘルプで案内されています(パブリッシャー センター ヘルプ: Google ニュースでの記事の重複を避ける)。
あわせて、配信先の記事から元の記事へリンクを張ってもらうよう、契約や依頼の段階で取り決めておくと安心です。
似たテーマの記事が複数ある場合
同じ検索語を狙った記事が複数あると、どちらも中途半端な評価になりがちです。内容が重なっている記事は 1 本に統合し、残さない記事の URL は、統合先へ 301 リダイレクトで転送します。
古い記事を残すか、直すか、削除するかの判断は、古いコンテンツの扱い方も参考にしてください。
他サイトに文章をコピーされたときの対応
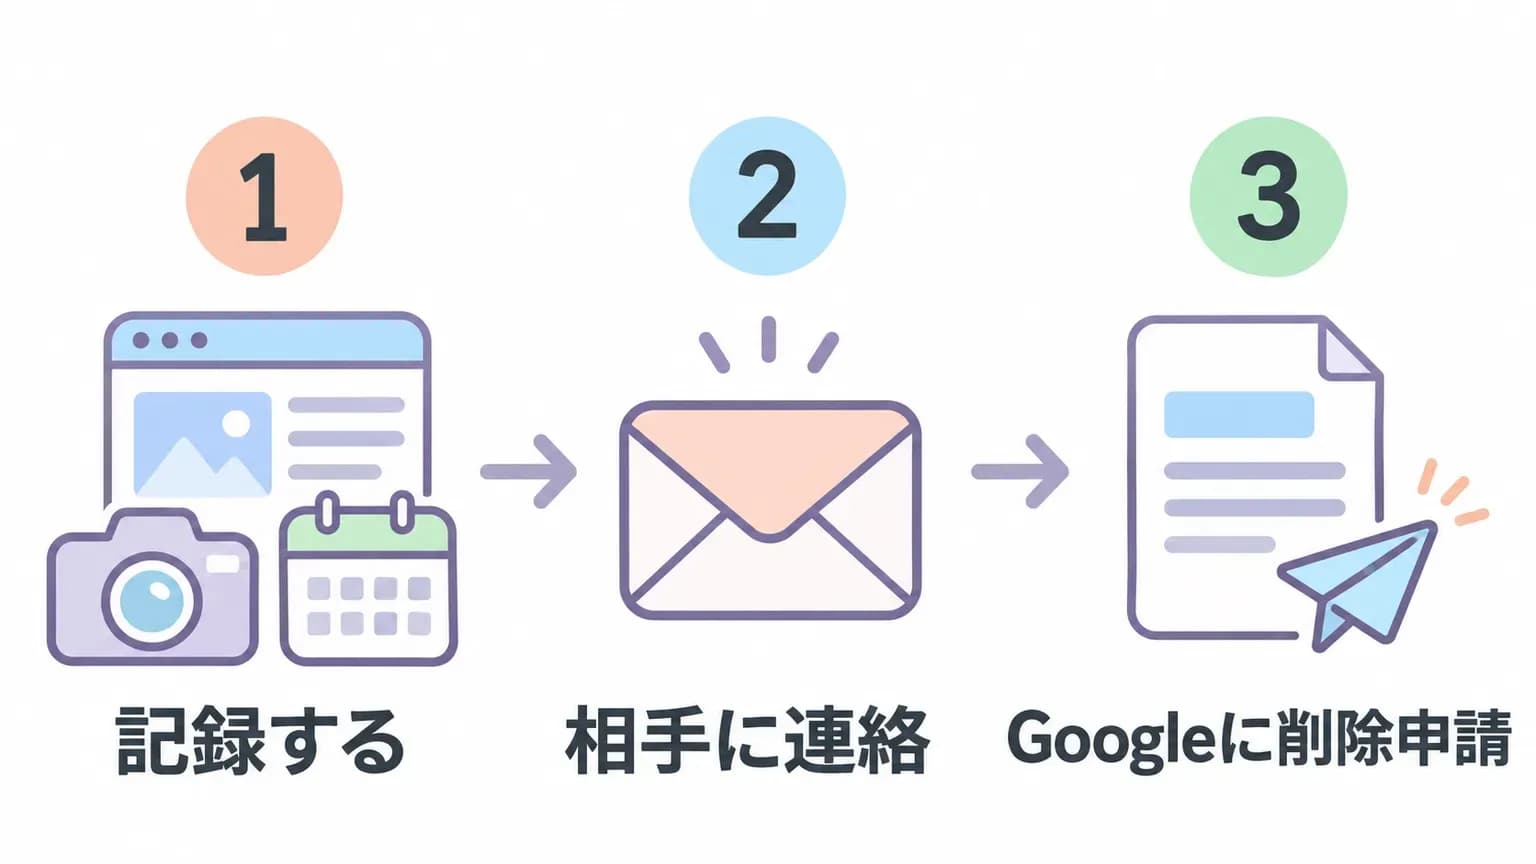
自社の文章が無断でコピーされても、それだけで自社サイトの評価が下がることは通常ありません。まずは落ち着いて、コピーの範囲を記録し、相手サイトへの連絡から始めます。それでも解決しない場合は、Google に削除を申請できます。
まずは相手サイトに連絡する
コピーされたページの URL、掲載日、画面の記録を残してから、問い合わせ窓口などで削除や出典の明記を依頼します。引用の範囲であれば、著作権の侵害にあたらないこともあります。判断に迷う場合は、弁護士などの専門家に相談してください。
Google に著作権侵害による削除を申請する
相手が応じない場合は、Google の「法的な理由でコンテンツを報告する」の窓口から、著作権侵害の申請を行えます(Legal ヘルプ: 法的な理由でコンテンツを報告する)。Google は、米国のデジタルミレニアム著作権法(DMCA)に沿って申請を受け付けています。
申請が認められると、該当ページが Google の検索結果から外されます。なお、相手のサイトそのものが消えるわけではありません。
日頃からできる備え
記事を公開したら、サーチコンソールの URL 検査から登録をリクエストしておくと、自社のページが早く見つけてもらいやすくなります。公開日や著者情報をページに明記し、原稿の作成記録を残しておくと、どちらが先に公開した文章かを示す材料になります。
まとめ
重複コンテンツは、同じ内容や、ほとんど同じ内容のページが複数の URL で見られる状態です。通常の重複にペナルティはなく、Google が代表の URL を 1 つ選ぶだけです。ただし、表示したいページが選ばれない、評価が分かれる、クロールに無駄が出る、といった損は起こります。
対策は、次の順で進めると迷いません。
- サーチコンソールの「ページのインデックス登録」レポートで、重複の理由が出ているページを確かめる
- URL 検査で「Google が選択した正規 URL」が意図どおりかを見る
- 不要な URL は 301 リダイレクト、残す URL は canonical タグで、代表の URL を伝える
- XML サイトマップと内部リンクを正規 URL にそろえる
- 似たテーマの記事は統合し、重複が生まれにくいサイト構造にする
検索順位の操作を狙った転載や、価値のないページの大量作成は、スパムとして扱われます。読者にとって意味のある違いがあるページだけを作ることが、いちばんの重複対策です。
重複コンテンツについてよくある質問
Q1. 重複コンテンツがあると、Google からペナルティを受けますか?
A. 通常の重複コンテンツであれば、ペナルティは受けません。Google は似たページをまとめて代表の URL を 1 つ選び、それを検索結果に表示します。ただし、他サイトの文章の転載や、価値のないページの大量作成など、検索順位の操作を狙った重複はスパムとして扱われます。
Q2. 何%くらい似ていると重複コンテンツとみなされますか?
A. Google は、重複とみなす一致率の基準を公表していません。判断の軸は、ヘッダーやフッターなどの共通部分ではなく、本文などの主要な内容がほぼ同じかどうかです。地名や商品名だけを入れ替えたページは、重複とみなされやすくなります。
Q3. 自分のサイトの重複コンテンツは、どうやって調べればよいですか?
A. サーチコンソールの「ページのインデックス登録」レポートで、「重複しています」で始まる理由が出ているページを確かめるのが確実です。気になるページは URL 検査で、「Google が選択した正規 URL」が表示してほしい URL と一致しているかを見てください。
Q4. 301 リダイレクトと canonical タグは、どちらを使えばよいですか?
A. 重複した URL をもう見せる必要がないなら 301 リダイレクト、ページを残す必要があるなら canonical タグを使います。www の有無や http と https の統一、記事の統合には 301 リダイレクトが向いています。並べ替えのパラメータ付き URL など、残しておく必要がある URL には canonical タグが向いています。
Q5. 他サイトに文章をコピーされた場合、どうすればよいですか?
A. まずはコピーされたページの URL や画面を記録し、相手サイトに削除や出典の明記を依頼します。応じてもらえない場合は、Google の法的な削除の窓口から、著作権侵害による検索結果からの削除を申請できます。
監修者紹介
中村 一浩
代表取締役CEO
株式会社ココログラフ 代表取締役CEO。1982年生まれ。高校卒業後に携帯販売業界にて、インターネットとハードウェアの急速な進化に触れた後、ウェブの面白さに惹かれ、2009年に株式会社ジオコードに入社。SEOを中心にウェブマーケティングを学び、同時にウェブ制作部門、システム開発部門のマネジメントも兼務。幅広いウェブ運用知識を有する。2018年に独立・起業し、検索エンジンだけでなく検索ユーザーにまで最適化する、SEOの上位互換サービスSUOを提供。SEO / SUOの独自AIレポートツール「ココミル」開発者。著書『現場のプロが教えるSEOの最新常識』(Amazon: https://amzn.to/4wPgYEK )
■得意領域
ウェブサイト改善 / SEO対策 / コンテンツマーケティング
Google 検索でココログラフの記事を優先表示させる
Google で優先するソースとして追加 Google で優先するソースとして追加